


注重隐私文件从不上传
所有音频工具。 无需上传。
直接在浏览器中编辑音频、转写文字、修改标签。免费、私密,文件从不离开你的设备。
免费 · 无需注册 · 不上传
全部音频工具
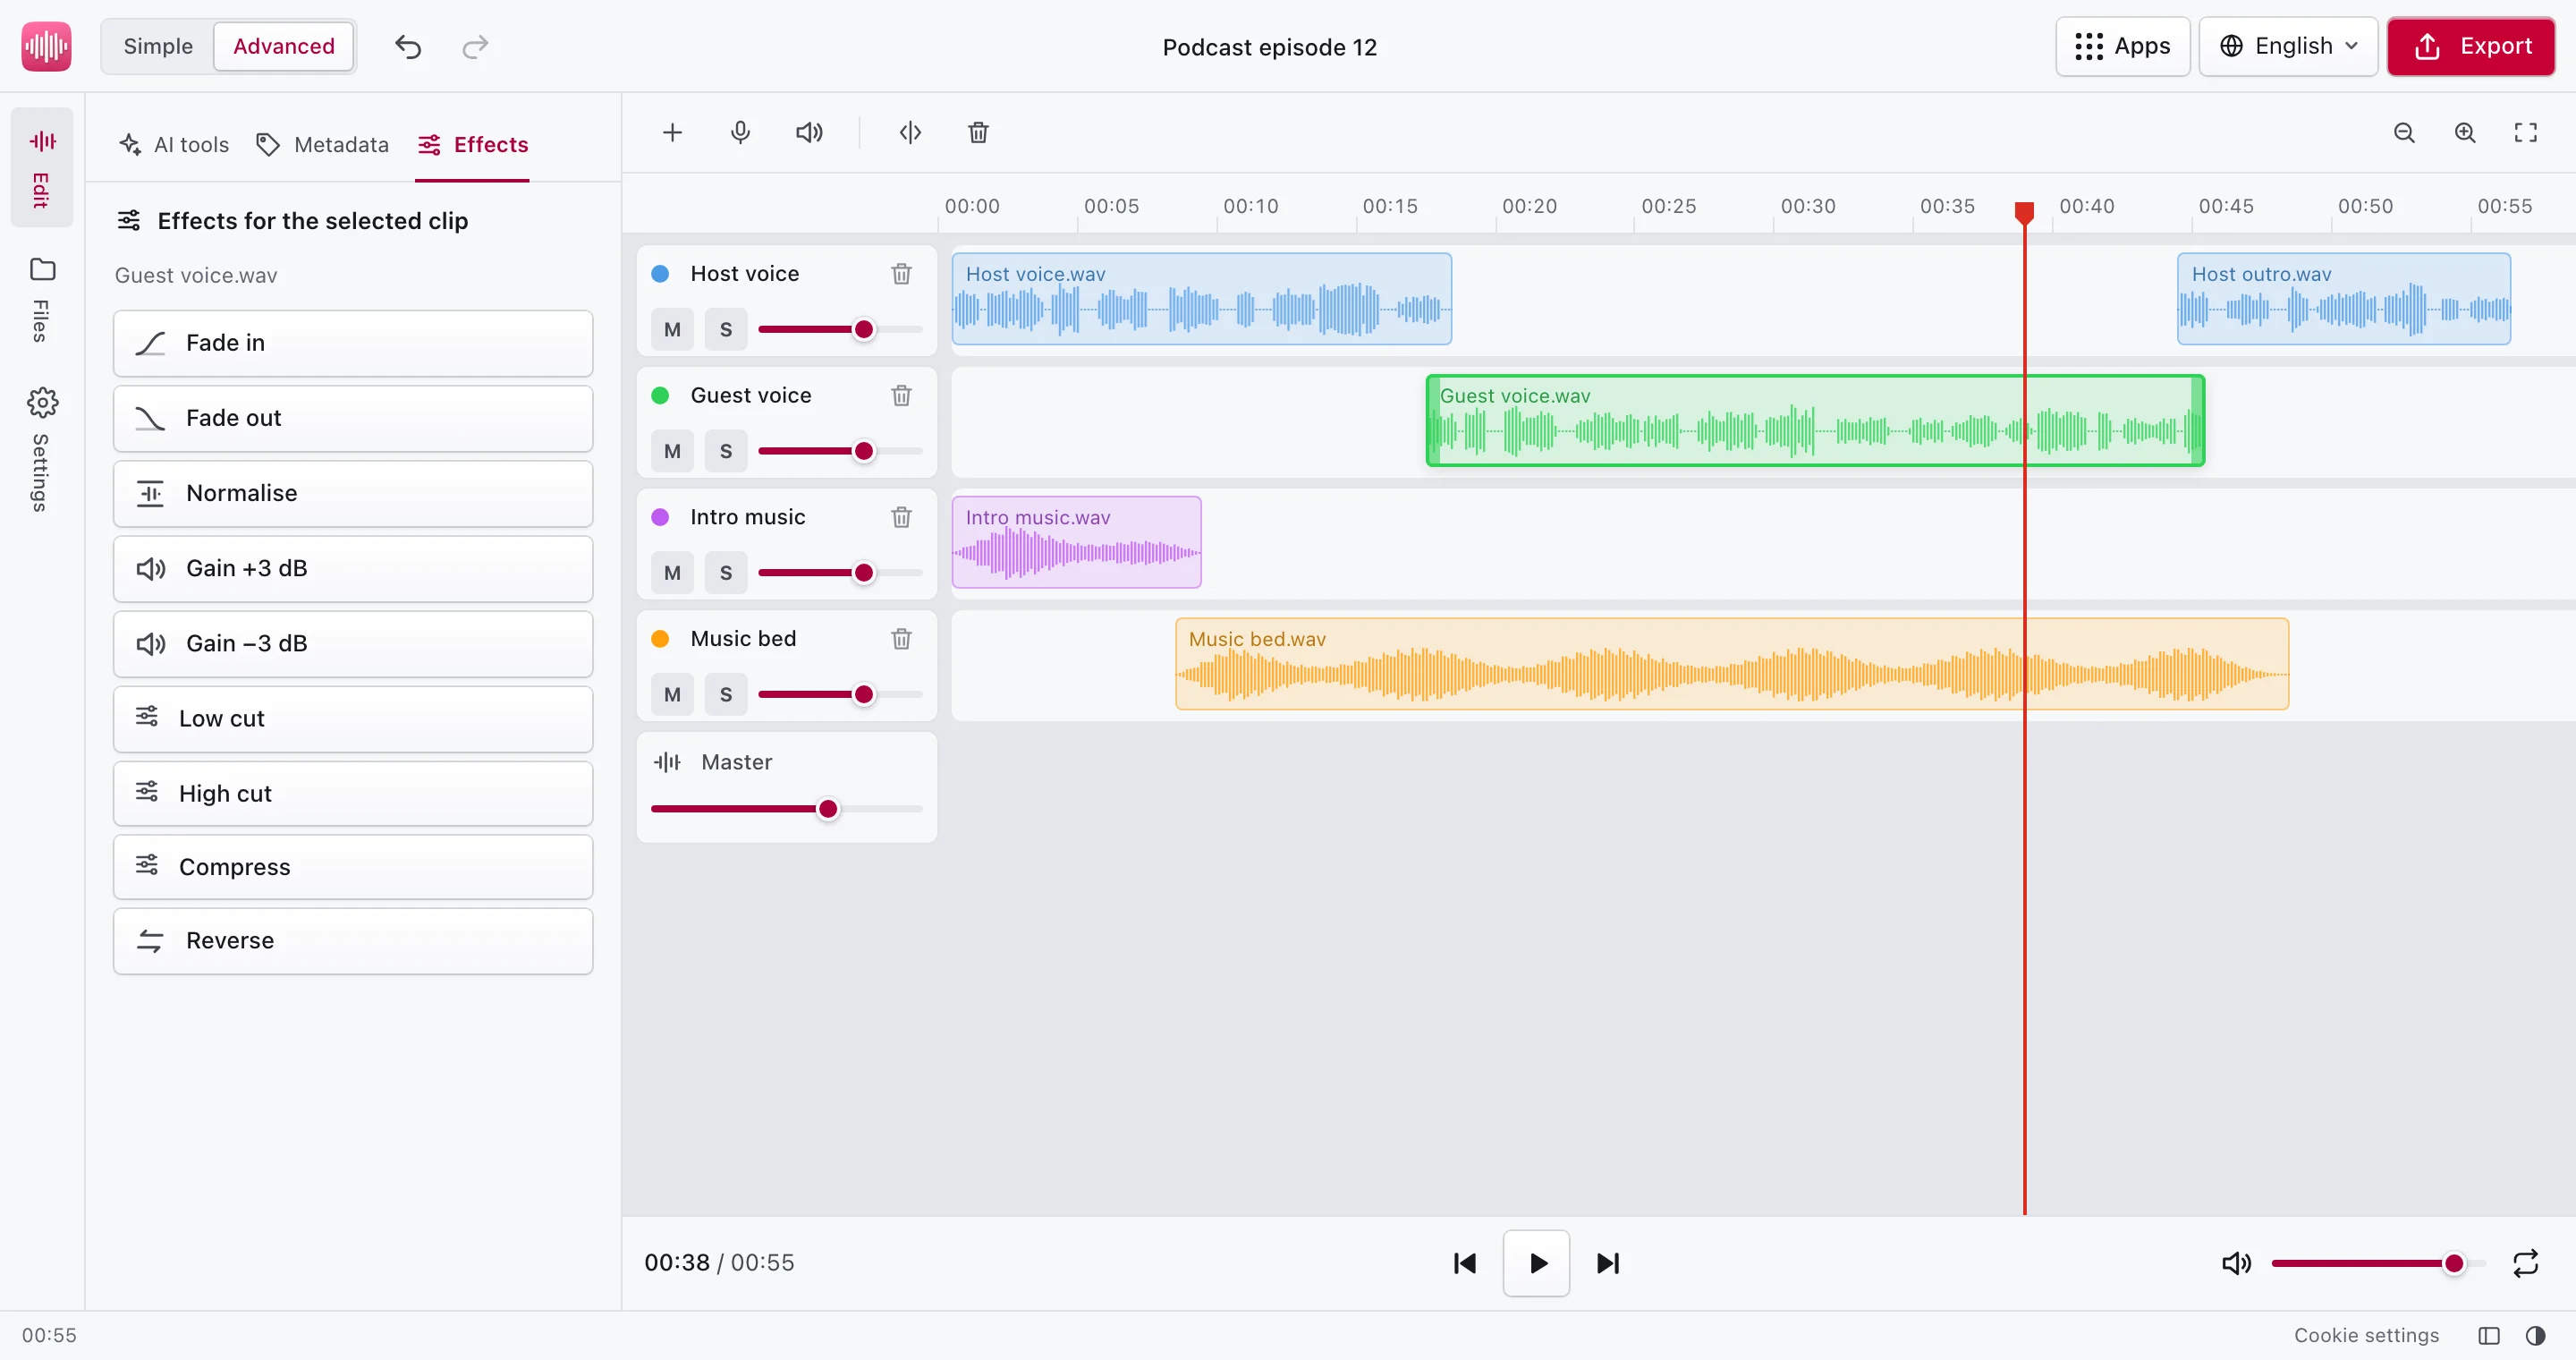
音频编辑器剪切裁剪,调整音量和速度,淡入淡出和标准化,然后导出。音频转文字 AI用本地 AI 将录音、语音备忘录和视频转成文字。音频转换把音频转成 MP3、M4A、OGG、FLAC 或 WAV。压缩音频让音频文件变小,方便发邮件和聊天。合并音频把多个音轨合并成一个文件。删除静音剪掉录音和语音备忘录中的停顿。提取视频中的音频把视频的声音保存为 MP3 等格式。铃声制作把任何歌曲变成 iPhone 或 Android 铃声。录音机用麦克风录音并保存文件。MP3 标签编辑器查看和编辑 MP3 元数据:标题、艺术家、专辑、封面和歌词。文字转语音 AI用自然的声音朗读任何文字,并保存为音频。在 Scissor Text 上提供
隐私来自设计,而不是承诺
Scissor Audio 的所有处理都在你的浏览器标签页中完成。录音、语音备忘录和采访都留在你的设备上;没有上传步骤,也没有能保存它们的服务器。
就连语音识别也在你的设备上运行:模型只需从本站下载一次,并由浏览器保存。了解工作原理。
为什么选择 Scissor Audio
从设计上保护隐私
文件在浏览器标签页中处理,从不上传。根本不存在能听到、保存或泄露它们的服务器。
快速,离线也能用
无需上传,无需等待。首次访问后,工具无需联网也能使用。
免费,没有附加条件
无需注册,不限文件,没有水印,没有广告。
常见问题
我的音频文件会被上传吗?
不会。每个工具都在浏览器标签页中读取文件并生成结果,不会向服务器发送任何内容。你可以在浏览器的网络面板中自行验证。
Scissor Audio 免费吗?
是的。无需注册,没有订阅,不限文件大小,也没有水印。处理在你自己的设备上进行,所以每个文件不会给我们带来任何成本。
没有服务器,音频转文字是怎么实现的?
它使用 OpenAI 的开源语音识别模型 Whisper。Scissor Audio 从自己的服务器下载一次模型,约 80 MB,然后由你的浏览器通过 WebAssembly 运行。
可以打开哪些文件?
MP3 标签编辑器可打开 MP3 文件。音频转文字可打开浏览器能播放的任何格式:MP3、WAV、M4A、AAC、OGG、Opus、FLAC 和 WebM,以及 MP4 和 MOV 视频中的声音。
可以离线使用吗?
可以。首次访问后,页面会由浏览器保存;语音模型下载一次后也会一直缓存。